Communautés BGP, quelques leçons du terrain
Ingénierie de trafic avec les communautés BGP entre deux datacenters : ce qui a marché, quelle astreinte a sonné la nuit, et les checklists qui en sont sorties.
Les communautés sont la plus vieille astuce du livre BGP, et toujours la plus sous-utilisée. Une communauté, c’est juste une étiquette que l’on attache à une route, mais les upstreams honorent un vocabulaire de plus en plus riche : prepend, épinglage de local-preference, blackhole, indications de région anycast. Utilisées cohéremment, elles transforment un setup bi-datacenter d’un « espoir de bascule » en un véritable volant de pilotage.
Cet article rassemble ce que nous avons vérifié en production lors de l’ingénierie d’un peering redondant pour un environnement opérateur, anonymisé comme toujours.
Le socle
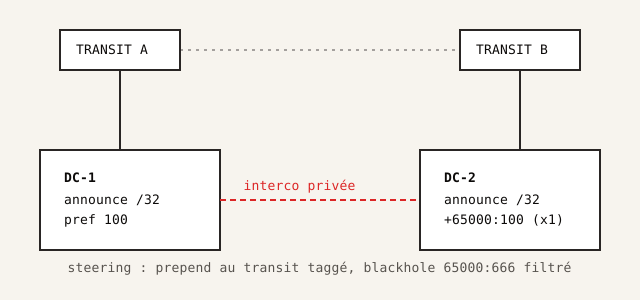
La topologie de référence est deux datacenters annonçant le même préfixe RIPE /32 via deux transitaires chacun, reliés par un interconnect privé pour la synchronisation. Toute la politique de steering tient en quatre valeurs de communautés BGP : prepend x1, x2, x3 et un blackhole protégé, appliquées cohéremment sur les deux sites.
La topologie est volontairement ennuyeuse : deux datacenters, un bloc RIPE /32 annoncé des deux côtés, interconnect privé pour la synchro. Les deux sites reçoivent les tables complètes de deux transitaires chacun. Ce qui est intéressant, ce n’est pas le schéma, c’est la politique qui y est attachée.
Les communautés qui ont fait leurs preuves
Trois conventions de communautés BGP ont porté tout le poids du steering : une échelle de prepend canonique (x1, x2, x3) détenue par un seul ASN, une réécriture des communautés entrantes en bordure dans cet espace canonique, et une communauté blackhole à débit limité protégée comme une règle de pare-feu. L’idée clé : maîtriser le vocabulaire de bout en bout.
Trois conventions ont porté tout le poids :
# Lisible, stable, documenté dans la base de peering
65000:100   prepend x1 vers le voisin marqué
65000:200   prepend x2
65000:300   prepend x3
65000:666   blackhole (filtre URF, protégé par max-prefix)
Deux détails comptent plus que le schéma lui-même :
- Un seul ASN possède le vocabulaire. Mélanger votre numérotation avec la table de communautés de chaque transit, c’est s’assurer des astreintes de 3 h du matin. On réécrit les communautés entrantes en bordure dans notre espace canonique, et seul l’espace canonique apparaît dans les route-maps.
- La communauté blackhole est gardée. Elle n’est annoncée qu’aux upstreams qui la filtrent correctement, et elle est limitée en débit de notre côté. Une communauté qui supprime du trafic est assez puissante pour mériter la même revue qu’une règle de pare-feu.
Les checklists
Deux artefacts opérationnels sont nés d’incidents de production : une procédure de drain par service et par direction qui déplace le trafic avec les communautés BGP avant de toucher aux sessions, avec les compteurs de paquets attendus à chaque étape, et un cron « prove it » de sondes synthétiques depuis l’extérieur des deux sites qui alerte quand le chemin gagnant diverge du chemin attendu.
Après l’astreinte inévitable (une maintenance où les annonces d’un site étaient retirées une minute entière avant que celles de l’autre site ne soient acceptées, laissant une fenêtre de rien), deux artefacts ont émergé :
- Une procédure de drain : par service, par direction, les étapes pour déplacer le trafic avec les communautés avant de toucher aux sessions, avec les compteurs de paquets attendus à chaque étape.
- Un cron « prove it » : des sondes synthétiques depuis l’extérieur des deux sites qui alertent quand le chemin gagnant n’est pas celui prévu. Du steering sans observation, c’est juste de la latence avec de la confiance en plus.
Ce que nous ferions différemment
Démarrer en actif-actif dès le premier jour avec une préférence par communautés au lieu de primaire/secours. Les configurations de secours s’ossifient vite : le jour où vous en avez besoin, elles décrivent un réseau qui n’existe plus. Et traitez votre politique de communautés comme de la documentation exécutable : l’écrire fait partie de la livrer.
Annoncer depuis les deux sites dès le premier jour avec des prepends, au lieu de démarrer en primaire/secours et d’évoluer ensuite. Les configurations de secours s’ossifient : le jour où vous en avez besoin, elles décrivent un réseau qui n’existe plus. L’actif-actif avec préférence par communautés se dégrade plus gracieusement que l’actif-n’importe-quoi.
Si vous ne devez retenir qu’une chose : votre politique de communautés n’est pas de la configuration, c’est de la documentation qui s’exécute. Traitez sa rédaction comme une partie de sa livraison.